Recursos
Resumen
Construir un agente de IA no depende del modelo, sino del loop de código que lo rodea. En esta guía aprenderás cómo funciona el ciclo observar, decidir, actuar y terminar que convierte un simple modelo en un agente capaz de usar herramientas, recordar contexto y validarse a sí mismo. Es contenido ideal para quien empieza en desarrollo de agentes con LLMs.
Por qué un modelo no es lo mismo que un agente
La diferencia entre un modelo y un agente no está en el modelo en sí, sino en el código que lo envuelve. Ese código permite que el agente observe, decida, actúe y determine si ya terminó su tarea [00:28].
A toda esa capa de código que recubre al modelo se le llama harness. Y aquí viene lo interesante: la mejor solución casi nunca es un mejor prompt, sino un harness que valide lo que el agente hace [02:35].
¿Qué es un harness en agentes de IA? Es todo el código que rodea al modelo, incluyendo el loop y un buen system prompt. Su trabajo es validar las acciones del agente y mantenerlo corriendo de forma confiable.
Esto importa porque los LLMs son agentes estocásticos: si les das el mismo input dos veces, no siempre responden lo mismo [02:03]. Un system prompt bien fijado ayuda, pero no garantiza consistencia por sí solo. Por eso necesitas un harness robusto para tareas sensibles como editar documentos.
Cómo afectan los errores y los límites al loop del agente
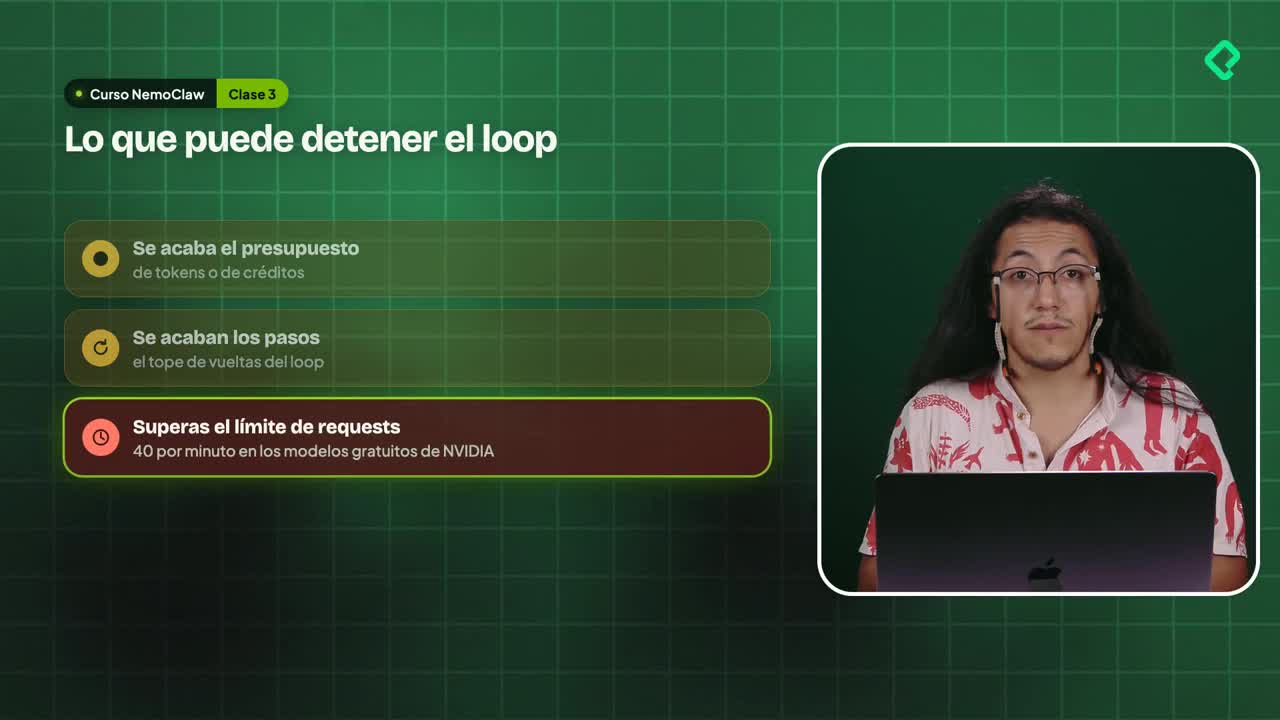
Los errores pueden venir directamente del loop. Puede que se te acabe el budget, superes el número total de pasos o rebases el límite de requests [00:55].
Si usas los modelos gratuitos de NVIDIA, tienes un tope de 40 requests por minuto [01:14]. Conocer este límite te evita cortes inesperados mientras pruebas tu agente.
Hay tres razones principales por las que una llamada termina, los llamados finish reasons:
- Stop: el agente ya terminó y debes cerrar el loop [05:30].
- Tool call: el agente llamó a una herramienta y necesita otro turno para continuar [05:40].
- Length: la llamada se cortó porque no permitiste suficientes tokens en la respuesta o el razonamiento [05:55].
Si tu agente se comporta raro, lo primero que debes revisar son estos finish reasons: ¿hace stop?, ¿se atora en un tool call infinito?, ¿o se quedó corto de longitud? [06:14].
Por qué la memoria lo cambia todo en un agente
Cada vez que llamas a un modelo, este no recuerda estados anteriores. Decimos que no tiene estado [01:30]. Si preguntas qué es un agente y luego vuelves a llamar sin contexto, no sabrá de qué hablabas.
Herramientas como ChatGPT y Claude resolvieron esto incluyendo toda la información anterior dentro del último mensaje, en lugar de empezar desde cero [01:48].
El ejemplo es claro. Si envías el mensaje "Me llamo Ada, recuérdalo" y luego preguntas cómo te llamas:
- Con histórico, el agente responde: "Te llamas Ada" [03:30].
- Sin histórico, responde: "No conozco tu nombre. ¿Quieres que te llame de alguna manera?" [03:40].
¿Por qué un LLM no recuerda la conversación anterior? Porque cada llamada no tiene estado: el modelo no guarda memoria entre peticiones. Para darle contexto debes enviarle el historial completo en cada turno.
Qué es el patrón ReAct y cómo funciona vuelta por vuelta
ReAct viene de reasoning y acting: razonar, actuar y observar [04:08]. Es el patrón que ordena cómo el agente piensa y usa herramientas.
Imagina que preguntas "¿Qué hora es en UTC?". El modelo razona que necesita saber la hora, pide el reloj como herramienta, observa el resultado y entonces responde: "Son las 16:05 en UTC" [04:20].
Aquí hay un punto crítico: el modelo no ejecuta código, solo ve texto y responde texto. Quien ejecuta el código es la computadora [05:08]. El modelo solo puede ver el nombre, la descripción y los parámetros de cada herramienta [04:40].
Cuando el modelo hace un tool call, el código ejecuta la herramienta y devuelve el resultado en el siguiente turno. Así se arma la memoria del agente.
Cómo se ve la libreta de contexto del agente
Ese contexto o libreta que arrastra el agente sigue un orden claro [07:00]:
- El system prompt con las instrucciones.
- Lo que tú le pediste.
- Lo que pidió el agente, por ejemplo el current time.
- La respuesta de la tool.
- El agente respondiendo y dando el stop.
Si tuvieras un budget de cuatro loops y el agente no termina en esos cuatro, el loop se detiene [06:40]. Por eso definir un tope de vueltas es parte del diseño.
Cuáles son los errores comunes al construir un agente
Un buen harness existe precisamente para contener estos fallos. Dos escenarios aparecen seguido.
El primero es el agente terco: lee el reloj en la vuelta uno, lo vuelve a leer en la dos, en la tres, en la cuatro, hasta que se acaba el budget [07:35]. Esto pasa cuando el system prompt o el harness no le dan la señal de que puede detenerse.
El segundo es el pedido roto: algo se rompe en el camino, la llamada se vuelve inválida y el modelo puede incluso alucinar el nombre de una herramienta [08:00].
La buena noticia es que ningún error, salvo un error en el código, rompe el loop del agente. Ese error se guarda como parte de la información y le da más contexto al agente para corregirse [08:20].
¿Te ha pasado que tu agente entra en un loop infinito? Cuéntame en los comentarios cómo lo resolviste.