📚 CLASE: DESPLIEGUE DE MODELOS GPT-4 Y EMBEDDINGS
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
Un sistema RAG necesita modelos que cumplan dos funciones diferentes: interpretar el contexto y generar respuestas, y convertir documentos en vectores para recuperar información relevante.
🟡 Desplegar correctamente ambos modelos permite conectar la base de conocimiento con la capacidad de generación de un LLM, utilizando servicios como Azure OpenAI.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
- 🔵 GPT-4: modelo de lenguaje que interpreta información y genera respuestas a partir del contexto proporcionado.
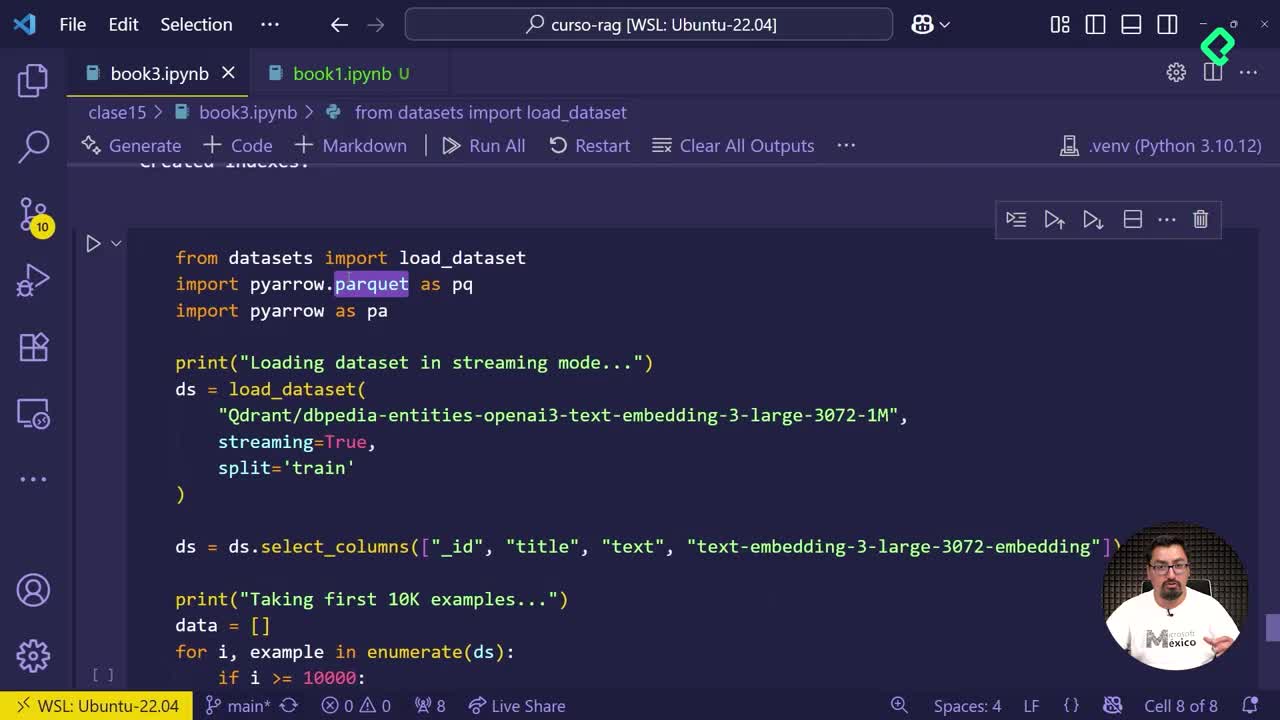
- 🔵 Modelo de embeddings: transforma textos en vectores numéricos para facilitar la búsqueda semántica.
- 🟡 Ambos modelos cumplen funciones diferentes y complementarias dentro de una arquitectura RAG.
- 🔴 No todos los modelos están disponibles en todas las regiones, suscripciones o niveles de servicio de Azure.
- 🟢 Configura los despliegues, verifica su disponibilidad y conecta cada modelo con el componente que lo necesita.
━━━━━━━━━━━━━━━━━━
🔑 LO IMPORTANTE
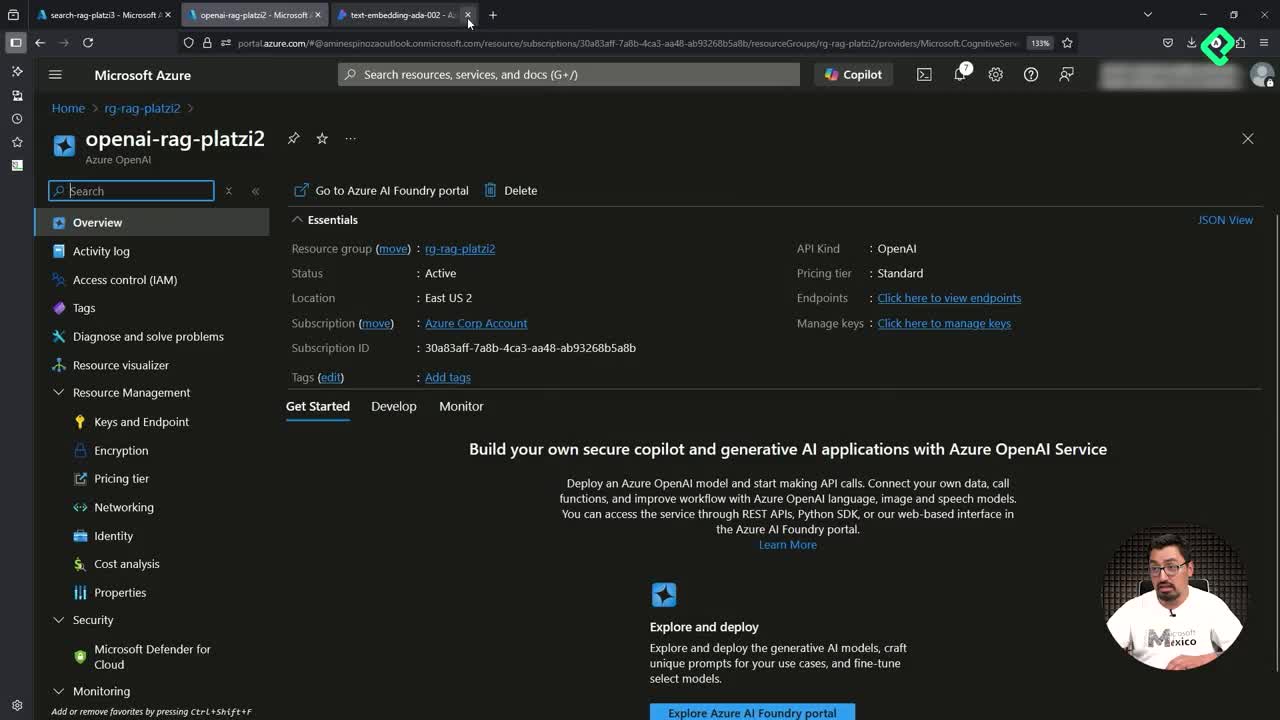
- 🔵 Deployment: instancia configurada de un modelo que tu aplicación puede invocar mediante un servicio.
- 🔵 Endpoint: dirección del servicio a la que se envían las solicitudes.
- 🔵 Clave de API: credencial utilizada para autenticar solicitudes cuando el servicio emplea ese mecanismo.
- 🔵 Tokens: unidades de texto que los modelos procesan; su consumo puede influir en el coste y los límites.
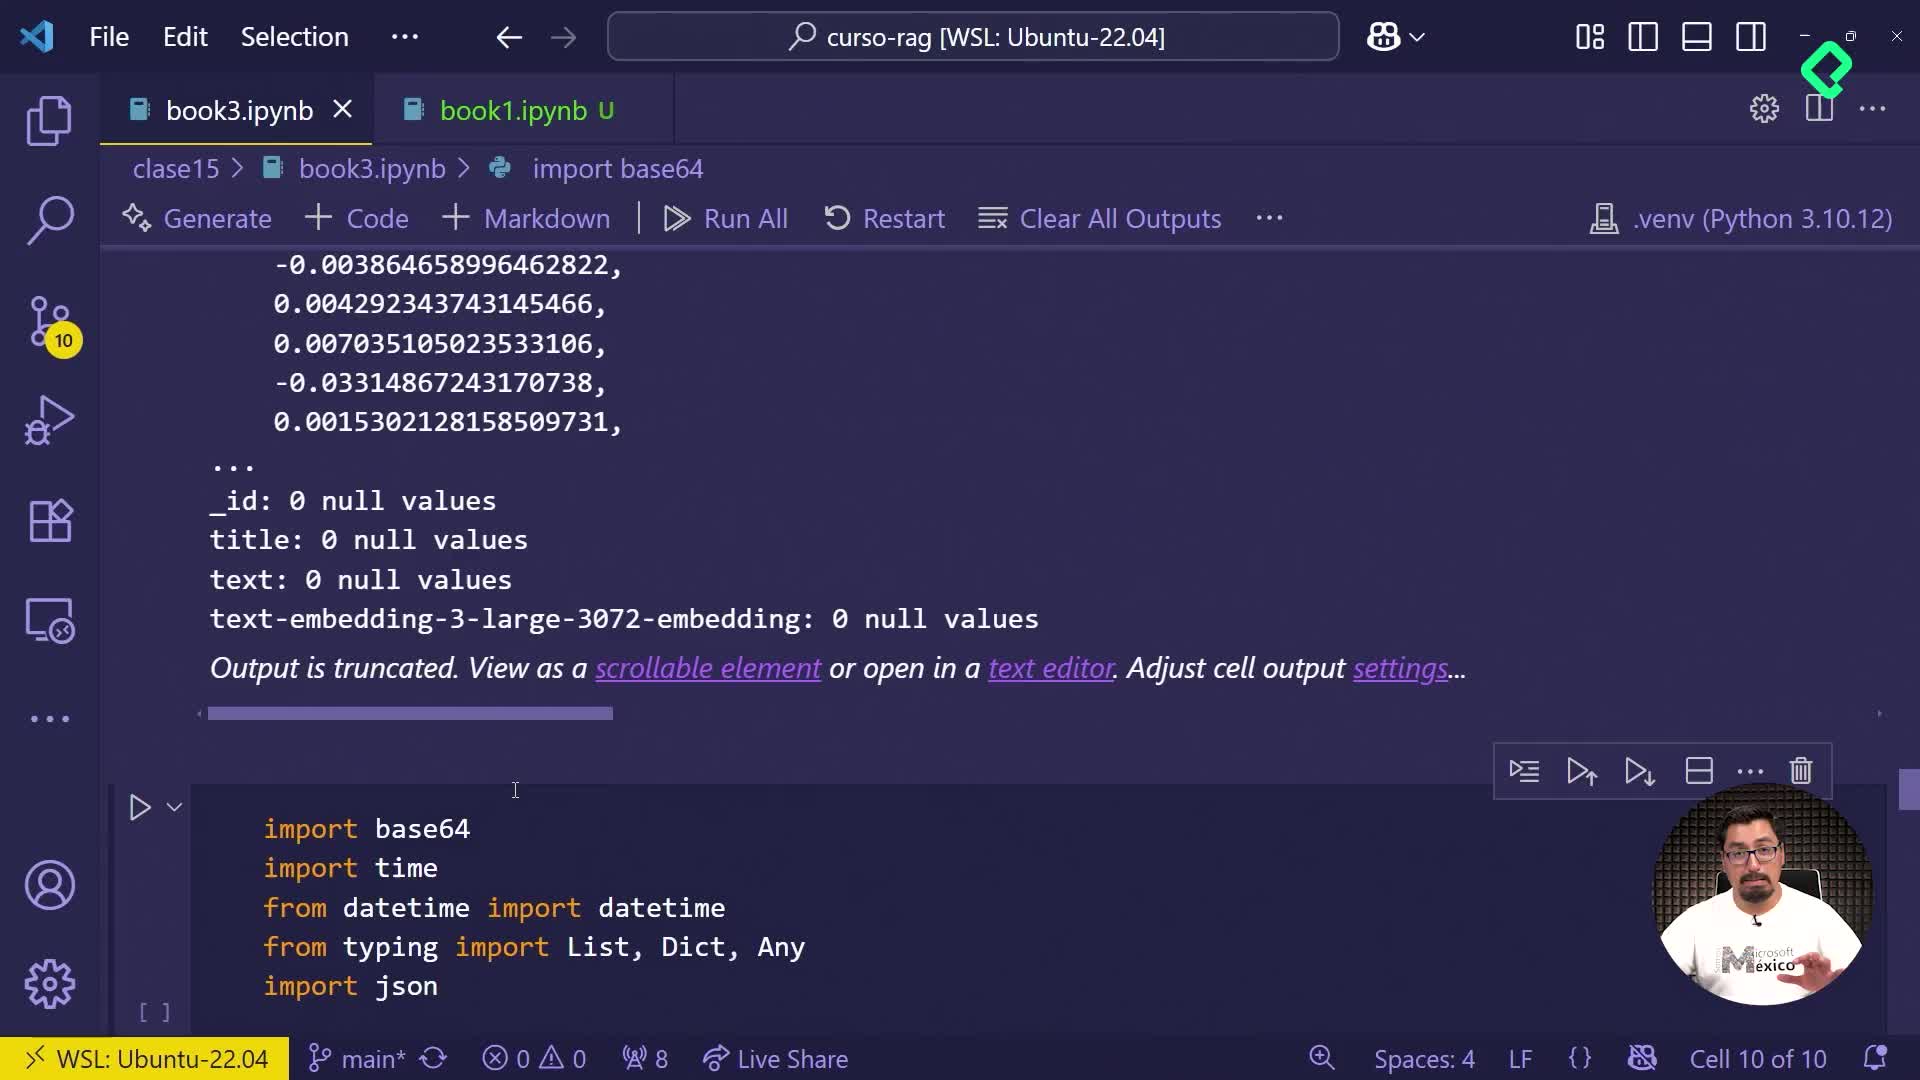
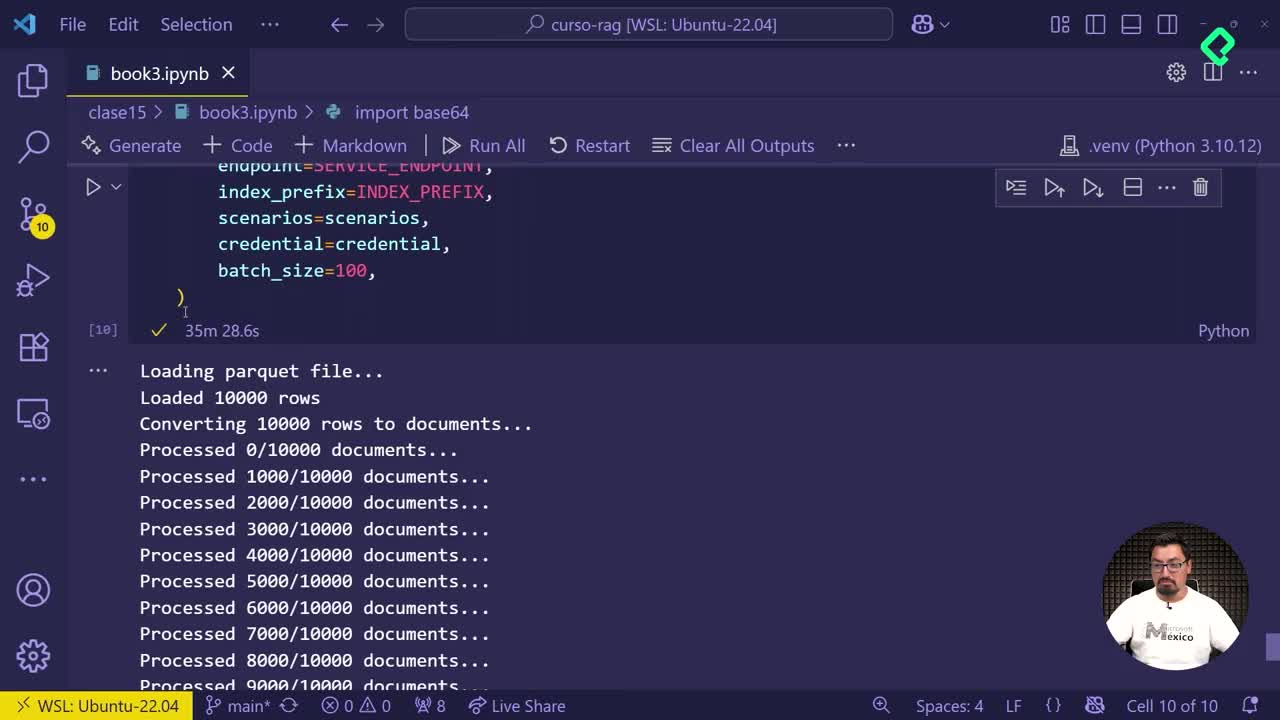
- 🟡 Los embeddings se generan para los documentos durante la indexación y para las consultas durante la búsqueda.
- 🔴 Los documentos y las consultas deben utilizar modelos de embeddings compatibles para que sus vectores puedan compararse correctamente.
- 🔴 Cambiar el modelo de embeddings puede requerir regenerar los vectores y reconstruir el índice.
- 🟡 El modelo de generación y el modelo de embeddings no tienen que ser el mismo.
- 🟣 Separar ambos despliegues permite ajustar el rendimiento, los costes y la capacidad de cada componente de forma independiente.
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
🟡 Documentos → Embeddings → Índice vectorial → Recuperación → GPT-4 → Respuesta
- 🔵 Indexación: convierte los fragmentos documentales en vectores.
- 🔵 Recuperación: transforma la pregunta en un vector y encuentra fragmentos relevantes.
- 🔵 Contextualización: incorpora los fragmentos recuperados a la solicitud enviada al LLM.
- 🔵 Generación: GPT-4 utiliza el contexto para producir una respuesta.
- 🟢 Validación: comprueba que la respuesta esté respaldada por los documentos recuperados.
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES PARA HOY
- 🟢 Identifica qué modelo de lenguaje y qué modelo de embeddings utilizarás en tu proyecto.
- 🟢 Comprueba que ambos modelos estén disponibles en tu suscripción y región de Azure.
- 🟢 Crea los despliegues con nombres claros que permitan distinguir su función.
- 🟢 Guarda los endpoints y las credenciales mediante variables de entorno protegidas.
- 🟢 Realiza una solicitud de prueba a cada despliegue y verifica que devuelve resultados válidos.
- 🟢 Genera embeddings para unos pocos documentos y comprueba que puedes recuperar fragmentos mediante una consulta.
- 🟢 Registra los errores, la latencia y el consumo para identificar posibles problemas de configuración.
━━━━━━━━━━━━━━━━━━
🟣 VENTAJA PROFESIONAL
- 🟣 Optimización de costes: reserva GPT-4 para tareas que necesiten sus capacidades y utiliza modelos más económicos cuando satisfagan los requisitos.
- 🟣 Arquitectura escalable: dimensiona los despliegues según la demanda y los límites de solicitudes.
- 🟣 Seguridad: evita incluir claves en Git y utiliza identidades administradas cuando estén disponibles y sean apropiadas.
- 🟣 Mantenimiento: documenta el nombre del despliegue, el modelo subyacente, su versión y sus parámetros de configuración.
- 🔴 Error que debes evitar: asumir que cambiar el nombre de un despliegue cambia el modelo o actualiza automáticamente su versión.
- 🟡 Consejo experto: mide la calidad de las respuestas con preguntas reales antes de aumentar la capacidad o migrar a modelos más grandes.
━━━━━━━━━━━━━━━━━━
📝 CIERRE
Un sistema RAG necesita algo más que un modelo potente: requiere coordinar correctamente la generación, la vectorización y la recuperación de información.
La diferencia entre un principiante y un profesional está en validar cada componente por separado y medir el rendimiento del sistema completo.
🟢 Reto: despliega un modelo de generación y otro de embeddings, prueba ambos individualmente y verifica que puedan trabajar juntos dentro de un flujo RAG.