

el curso deberia renombrarse "Como usar Azure para desplegar un servicio de IA con RAG"
sin embargo , los primeros videos antes de iniciar con azure, en el que se hablaba la teoria, estan 10/10
Conectar un motor de búsqueda con un modelo de lenguaje suele sonar complejo, pero con Azure AI Foundry puedes integrar tu sistema RAG con un LLM en cuestión de clics. Aquí verás cómo enlazar tu índice de Azure AI Search con un modelo gpt-4 desplegado, sin escribir código, y obtener respuestas respaldadas con citas reales de tus documentos.
Cómo conectar Azure AI Search con un modelo gpt-4 desplegado
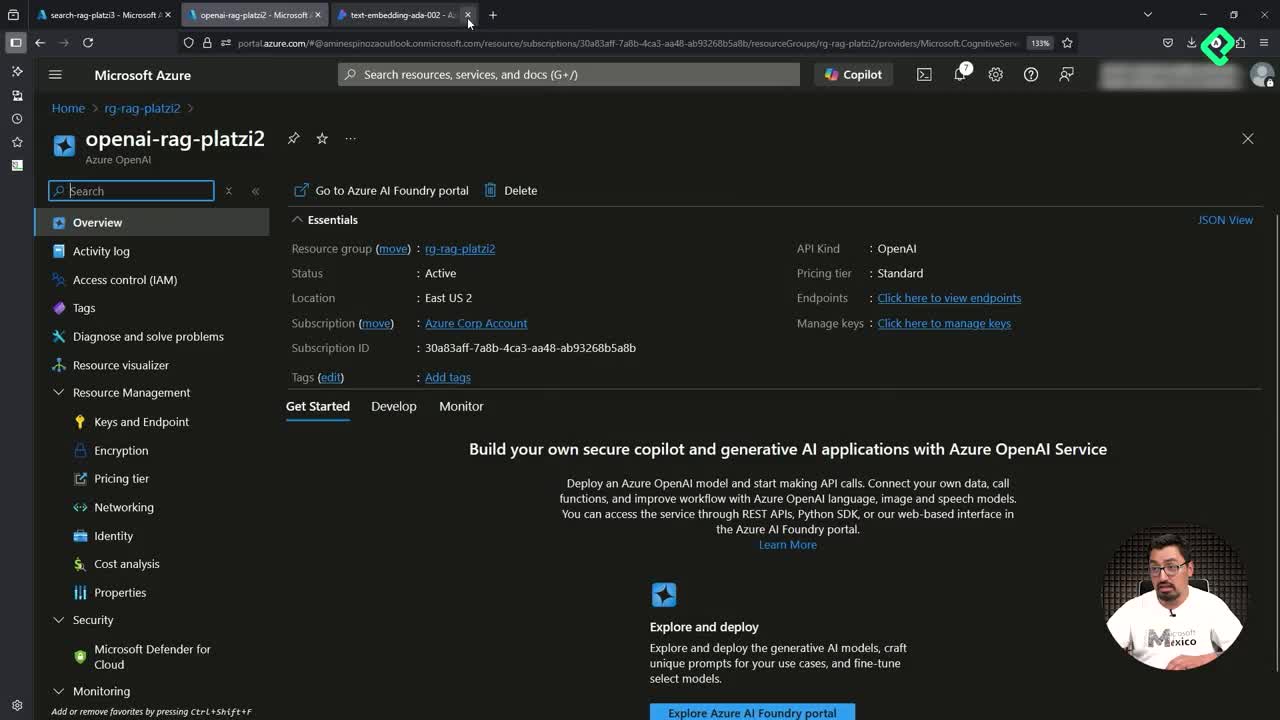
Desde el grupo de recursos en Azure, abres Azure OpenAI y entras al portal de Azure AI Foundry. Ahí, la categoría Chat aparece como primera opción y te lleva directo al Chat Playground, donde ya está cargado el modelo gpt-4 desplegado dentro de Platzi2 [0:30].
Antes de mandar prompts o cargar contexto, tienes la opción de añadir tu propia información seleccionando una fuente de datos. Esa fuente puede ser Azure AI Search, aunque también funciona con endpoints de LangChain, Prompt Flow o Elasticsearch [1:05].
¿Qué es un sistema RAG? Es una arquitectura donde un LLM consulta una base de conocimiento externa, como un índice de búsqueda, antes de responder. Así genera respuestas basadas en tus documentos y no solo en su entrenamiento.
Por qué necesitas tener habilitada la búsqueda vectorial
Al seleccionar tu suscripción y el componente search-platzi-2, eliges el índice de Azure AI dentro de los que generaste en clases pasadas. El detalle crítico aquí es que el índice debe tener vector search habilitado para mejorar la calidad de los resultados [1:40].
Después, Foundry te pregunta cómo quieres manejar la recuperación de información. Las opciones replican lo que hiciste en Jupyter con métodos híbridos:
La elección recomendada es vector y keyword, porque la búsqueda semántica encarece la operación y muchas veces no está activada en el servicio de búsqueda [2:10].
Cómo autenticar y validar la conexión sin crear identidades
El siguiente paso pide definir el método de acceso. Si no creaste identidades administradas, seleccionas que todo se haga vía API. Foundry valida la conexión y, una vez aprobada, guardas y cierras los cambios [2:40].
A partir de ese momento aparece un bloque que indica que tu agente ya está usando ese índice como fuente de conocimiento. Puedes escribir directamente en el playground una consulta como what is Contoso y el modelo responde con información generada a partir de tus documentos.
¿Cómo sé que la respuesta viene de mis documentos y no del modelo base? Foundry muestra referencias numeradas (citation1, citation2) junto a cada respuesta, indicando el archivo fuente exacto del que se extrajo la información.
Qué tan específicas pueden ser las respuestas con tu RAG
Probando con una pregunta más concreta del plan de seguros Northwind, copiada desde un archivo en VS Code, la respuesta del agente se vuelve mucho más precisa. Las citas apuntan a archivos específicos:
Estos dos PDFs viven dentro del sistema RAG y respaldan cada afirmación generada por el LLM [3:30]. Esa trazabilidad es lo que diferencia un chatbot genérico de un agente empresarial confiable.
Cómo exportar el agente a tu propia aplicación
Para llevar este agente fuera de Foundry, basta con hacer clic en View Code. Ahí eliges el lenguaje de programación que prefieras y obtienes el snippet listo para integrar.
Las opciones de autenticación que aparecen son:
Seleccionas la autenticación por llave, copias el código y lo pegas en tu aplicación. Con eso, tu agente replica exactamente el comportamiento que viste en el playground [4:15].
Qué ganas con esta integración sin código
El flujo completo te deja con un agente conversacional respaldado por tu propio conocimiento, listo para desplegar donde quieras. Pocos clics, cero líneas escritas desde cero, y un sistema que cita sus fuentes.
Esto es especialmente útil cuando trabajas con documentación interna, manuales técnicos o bases de conocimiento que el LLM base no conoce. La combinación de vector search, búsqueda híbrida y un modelo gpt-4 te da control sobre la calidad y la trazabilidad de cada respuesta.
¿Ya probaste conectar tu propio índice de Azure AI Search con un modelo en Foundry? Cuéntame en los comentarios qué tipo de documentos cargaste y qué método de recuperación te dio mejores resultados.
Conectar un motor de búsqueda con un modelo de lenguaje suele sonar complejo, pero con Azure AI Foundry puedes integrar tu sistema RAG con un LLM en cuestión de clics. Aquí verás cómo enlazar tu índice de Azure AI Search con un modelo gpt-4 desplegado, sin escribir código, y obtener respuestas respaldadas con citas reales de tus documentos.
Desde el grupo de recursos en Azure, abres Azure OpenAI y entras al portal de Azure AI Foundry. Ahí, la categoría Chat aparece como primera opción y te lleva directo al Chat Playground, donde ya está cargado el modelo gpt-4 desplegado dentro de Platzi2 [0:30].
Antes de mandar prompts o cargar contexto, tienes la opción de añadir tu propia información seleccionando una fuente de datos. Esa fuente puede ser Azure AI Search, aunque también funciona con endpoints de LangChain, Prompt Flow o Elasticsearch [1:05].
¿Qué es un sistema RAG? Es una arquitectura donde un LLM consulta una base de conocimiento externa, como un índice de búsqueda, antes de responder. Así genera respuestas basadas en tus documentos y no solo en su entrenamiento.
Al seleccionar tu suscripción y el componente search-platzi-2, eliges el índice de Azure AI dentro de los que generaste en clases pasadas. El detalle crítico aquí es que el índice debe tener vector search habilitado para mejorar la calidad de los resultados [1:40].
Después, Foundry te pregunta cómo quieres manejar la recuperación de información. Las opciones replican lo que hiciste en Jupyter con métodos híbridos:
La elección recomendada es vector y keyword, porque la búsqueda semántica encarece la operación y muchas veces no está activada en el servicio de búsqueda [2:10].
El siguiente paso pide definir el método de acceso. Si no creaste identidades administradas, seleccionas que todo se haga vía API. Foundry valida la conexión y, una vez aprobada, guardas y cierras los cambios [2:40].
A partir de ese momento aparece un bloque que indica que tu agente ya está usando ese índice como fuente de conocimiento. Puedes escribir directamente en el playground una consulta como what is Contoso y el modelo responde con información generada a partir de tus documentos.
¿Cómo sé que la respuesta viene de mis documentos y no del modelo base? Foundry muestra referencias numeradas (citation1, citation2) junto a cada respuesta, indicando el archivo fuente exacto del que se extrajo la información.
Probando con una pregunta más concreta del plan de seguros Northwind, copiada desde un archivo en VS Code, la respuesta del agente se vuelve mucho más precisa. Las citas apuntan a archivos específicos:
Estos dos PDFs viven dentro del sistema RAG y respaldan cada afirmación generada por el LLM [3:30]. Esa trazabilidad es lo que diferencia un chatbot genérico de un agente empresarial confiable.
Para llevar este agente fuera de Foundry, basta con hacer clic en View Code. Ahí eliges el lenguaje de programación que prefieras y obtienes el snippet listo para integrar.
Las opciones de autenticación que aparecen son:
Seleccionas la autenticación por llave, copias el código y lo pegas en tu aplicación. Con eso, tu agente replica exactamente el comportamiento que viste en el playground [4:15].
El flujo completo te deja con un agente conversacional respaldado por tu propio conocimiento, listo para desplegar donde quieras. Pocos clics, cero líneas escritas desde cero, y un sistema que cita sus fuentes.
Esto es especialmente útil cuando trabajas con documentación interna, manuales técnicos o bases de conocimiento que el LLM base no conoce. La combinación de vector search, búsqueda híbrida y un modelo gpt-4 te da control sobre la calidad y la trazabilidad de cada respuesta.
¿Ya probaste conectar tu propio índice de Azure AI Search con un modelo en Foundry? Cuéntame en los comentarios qué tipo de documentos cargaste y qué método de recuperación te dio mejores resultados.
el curso deberia renombrarse "Como usar Azure para desplegar un servicio de IA con RAG"
sin embargo , los primeros videos antes de iniciar con azure, en el que se hablaba la teoria, estan 10/10
Es posible que Microsoft tiene alguna influencia para la realización del curso, ya que aparentemente el profesor tiene relación con esa empresa y a lo mejor eso lleva a que se use Azure para crear los ejemplos que se presentan
suena hermoso pero que tan caro sera pagar eso a windows? cuando la mayoría de arquitecturas están basadas en costo
Tengo el siguiente error al hacer la consulta luego de cargar los datos. Error: 400: An error occurred when calling Azure OpenAI: Server responded with status 429. Error message: {'error': {'code': '429', 'message': 'Rate limit is exceeded. Try again in 60 seconds.'}}
?
📚 CLASE: RAG con GPT-4 sin escribir código
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
Azure AI Foundry permite conectar un modelo GPT-4 con un índice de Azure AI Search para crear un asistente que responda preguntas basándose en documentos propios, sin programar toda la integración manualmente.
La clave es configurar la fuente de conocimiento, seleccionar el método de búsqueda y comprobar que las respuestas estén respaldadas por citas de los documentos.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
- 🔵 Azure AI Foundry: permite configurar experiencias de IA generativa y conectar modelos con fuentes de datos.
- 🔵 RAG: recupera información relevante de documentos antes de generar una respuesta.
- 🟢 Conecta el modelo desplegado con tu índice existente de Azure AI Search.
- 🟡 La búsqueda híbrida combina coincidencias por palabras clave y similitud vectorial.
- 🟢 Utiliza las citas de las respuestas para verificar qué documentos respaldan la información generada.
━━━━━━━━━━━━━━━━━━
🔑 LO IMPORTANTE
- 🟢 Abre Azure AI Foundry y accede al playground de chat del modelo desplegado.
- 🟢 Añade una fuente de datos y selecciona Azure AI Search como proveedor de conocimiento.
- 🔵 El índice debe tener los campos y la configuración necesarios para el método de recuperación seleccionado.
- 🟢 Selecciona el servicio de búsqueda, el índice y el método de autenticación correspondiente.
- 🔵 Keyword: busca coincidencias textuales.
- 🔵 Vector: recupera fragmentos según su similitud semántica.
- 🔵 Vector + Keyword: combina ambas estrategias mediante búsqueda híbrida.
- 🟡 Prueba primero la búsqueda híbrida y compárala con otras opciones usando las mismas preguntas.
- 🔴 No confundas una respuesta convincente con una respuesta respaldada por tus documentos.
- 🟢 Comprueba las citas y abre los documentos originales para verificar las afirmaciones importantes.
- 🔴 No expongas claves de API dentro de código frontend ni en repositorios públicos.
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
🟣 RAG sin código = modelo desplegado + índice de conocimiento + recuperación + respuesta fundamentada.
- 🔵 Modelo: interpreta la pregunta y redacta la respuesta.
- 🔵 Índice: proporciona los fragmentos relevantes de tus documentos.
- 🟢 Recuperación: busca información mediante palabras clave, vectores o una combinación.
- 🟢 Validación: verifica las citas y comprueba si el contenido recuperado respalda la respuesta.
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES PARA HOY
- 🟢 Comprueba que tu servicio de Azure AI Search tenga documentos indexados y que puedas consultarlos.
- 🟢 Abre el playground de chat en Azure AI Foundry y selecciona tu modelo desplegado.
- 🟢 Configura Azure AI Search como fuente de datos y selecciona el índice correcto.
- 🟢 Configura la autenticación utilizando el método permitido por tu entorno.
- 🟢 Formula cinco preguntas cuyas respuestas estén en los documentos indexados.
- 🟢 Formula una pregunta cuya respuesta no aparezca en los documentos.
- 🟢 Revisa las citas, la relevancia de los fragmentos y el comportamiento del asistente cuando falta información.
- 🟢 Si funciona, utiliza la opción para visualizar el código de integración y estudia cómo llevarlo a tu aplicación.
━━━━━━━━━━━━━━━━━━
🟣 VENTAJA PROFESIONAL
- 🟣 Buena práctica adicional: comienza con una demo sin código para validar la arquitectura antes de invertir tiempo en una implementación propia.
- 🟣 Conserva un conjunto de preguntas de prueba para comparar modelos y estrategias de recuperación.
- 🟣 Si necesitas control sobre la interfaz, los permisos, los registros y la lógica de negocio, integra el sistema desde tu backend.
- 🔴 El código generado por la herramienta no elimina la necesidad de gestionar secretos, errores, límites de uso y autenticación.
- 🟣 Para aplicaciones empresariales, evalúa Microsoft Entra ID e identidades administradas cuando sean compatibles con tu arquitectura y configuración.
- 🟡 La integración visual acelera el prototipo; una solución de producción necesita pruebas de seguridad, calidad y costes.
━━━━━━━━━━━━━━━━━━
📝 CIERRE
Un principiante conecta GPT-4 con sus documentos y celebra que responde. Un profesional verifica las fuentes, mide la calidad y prepara una integración segura.
🟢 Reto práctico: conecta tu índice de Azure AI Search con el modelo en Foundry, formula preguntas reales y verifica que cada respuesta importante esté respaldada por sus documentos.
wow
Gracias