📚 CLASE: EMBEDDINGS Y VECTORIZACIÓN EN RAG
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
Los embeddings convierten textos en vectores numéricos que representan aspectos de su significado. Esto permite que un sistema RAG encuentre información relacionada con una pregunta, aunque no utilice exactamente las mismas palabras.
🟡 La calidad de los embeddings influye directamente en la capacidad del sistema para recuperar información relevante y generar respuestas útiles.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
- 🔵 Embeddings: representaciones numéricas del significado de textos, frases o documentos.
- 🔵 Vectorización: proceso mediante el cual el contenido se transforma en vectores que pueden compararse matemáticamente.
- 🟡 Los textos con significados similares suelen producir vectores cercanos dentro del espacio vectorial.
- 🔵 Una base de datos vectorial almacena y permite buscar estos vectores de manera eficiente.
- 🟢 Utiliza embeddings para recuperar fragmentos relevantes antes de enviar el contexto a un modelo de lenguaje.
━━━━━━━━━━━━━━━━━━
🔑 LO IMPORTANTE
- 🔵 Vector: lista de números que representa un texto dentro de un espacio matemático.
- 🔵 Modelo de embeddings: modelo especializado en transformar contenido en representaciones vectoriales.
- 🔵 Similitud coseno: medida habitual para comparar la orientación de dos vectores y estimar su similitud.
- 🟡 Búsqueda semántica: encuentra información por su significado, no solamente por coincidencias exactas de palabras.
- 🔴 Los embeddings no garantizan que dos textos similares sean equivalentes ni que una respuesta sea verdadera.
- 🔴 No mezcles vectores generados por modelos incompatibles: las consultas y los documentos deben utilizar representaciones comparables.
- 🟡 Cambiar de modelo de embeddings puede requerir volver a vectorizar e indexar todos los documentos existentes.
- 🟣 La elección del modelo debe considerar idioma, dominio, calidad de recuperación, coste y velocidad.
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
🟡 Texto → Embedding → Vector → Búsqueda por similitud → Fragmentos relevantes → LLM
- 🔵 Texto: documento o pregunta del usuario.
- 🔵 Embedding: modelo que convierte el texto en una representación numérica.
- 🔵 Vector: representación que puede almacenarse y compararse.
- 🔵 Búsqueda: identifica los vectores más relacionados con la consulta.
- 🟢 Recuperación: entrega los fragmentos seleccionados al LLM para generar una respuesta contextualizada.
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES PARA HOY
- 🟢 Selecciona cinco fragmentos de documentación que pertenezcan a un mismo tema.
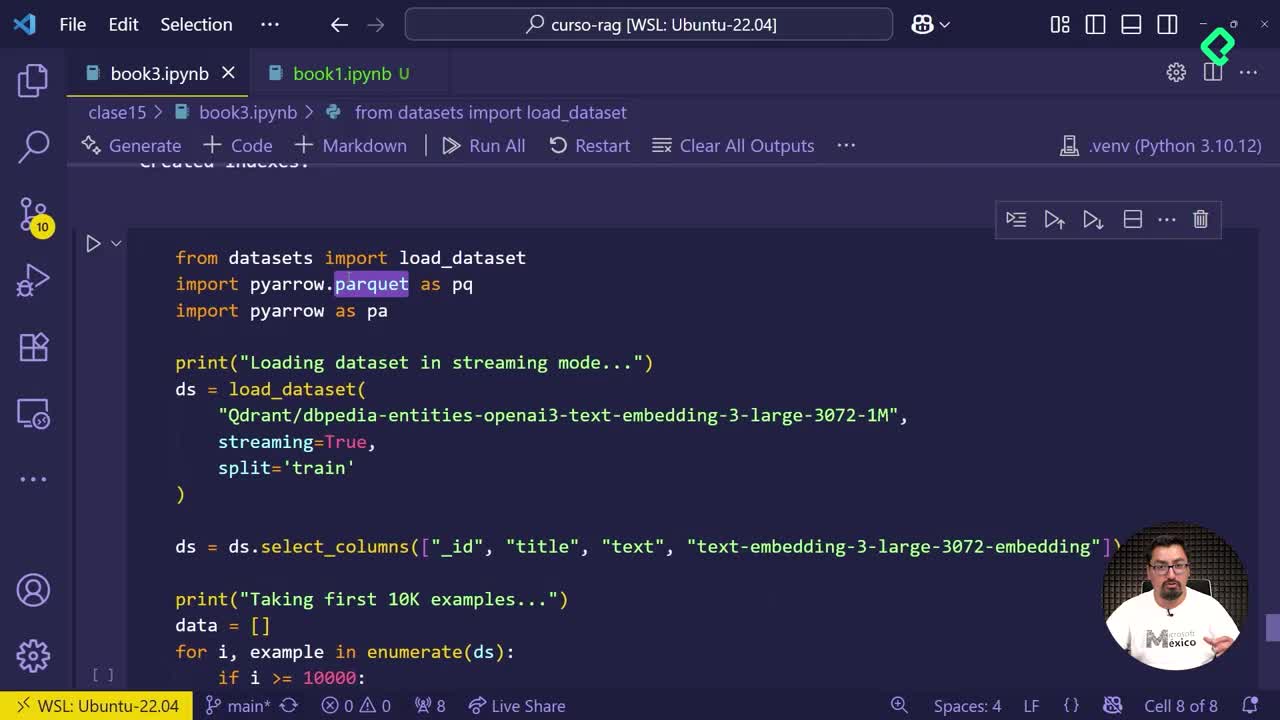
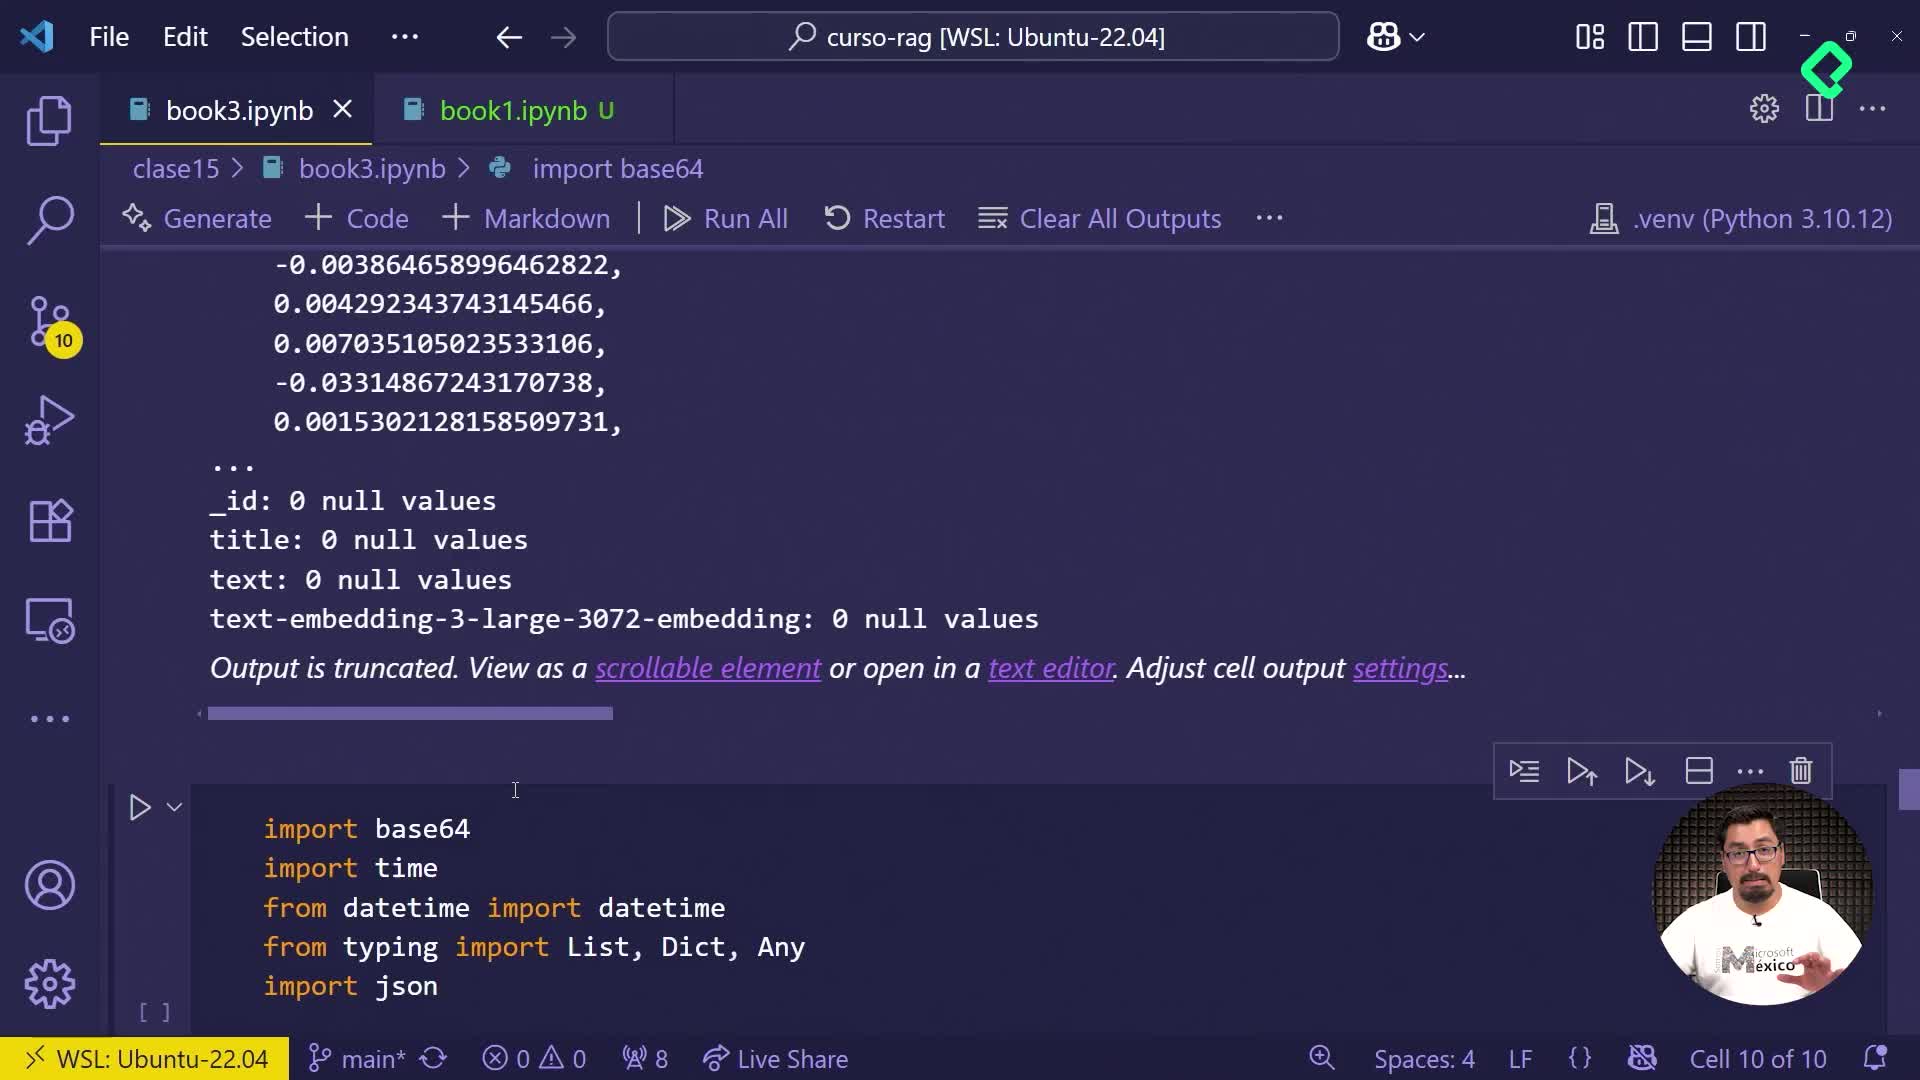
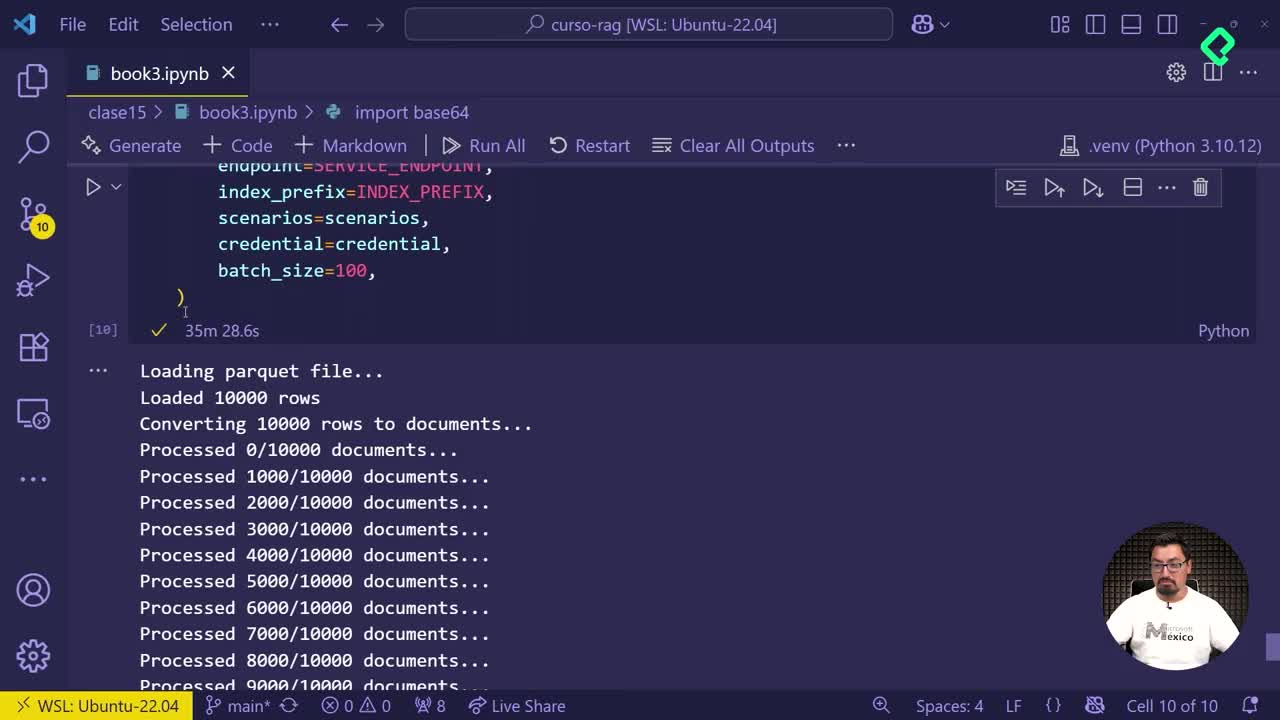
- 🟢 Genera embeddings de esos fragmentos utilizando un modelo compatible con el idioma de tus documentos.
- 🟢 Vectoriza una pregunta relacionada con el contenido y compárala con los fragmentos almacenados.
- 🟢 Ordena los resultados por similitud y comprueba si el fragmento correcto aparece entre los primeros.
- 🟢 Prueba una pregunta con palabras diferentes a las del documento, pero con el mismo significado.
- 🟢 Registra las consultas que recuperan información incorrecta y revisa el modelo, los fragmentos y los criterios de búsqueda.
━━━━━━━━━━━━━━━━━━
🟣 VENTAJA PROFESIONAL
- 🟣 Aplicación real: los embeddings permiten construir asistentes que buscan información en manuales, documentación técnica y bases de conocimiento empresariales.
- 🟣 Optimización: evalúa los resultados con preguntas reales antes de cambiar de modelo o aumentar los recursos de infraestructura.
- 🟣 Estrategia avanzada: combina búsqueda vectorial con búsqueda por palabras clave cuando necesites recuperar tanto conceptos semánticos como identificadores exactos.
- 🟣 Control de costes: genera los embeddings de los documentos durante la indexación y reutilízalos mientras el contenido no cambie.
- 🔴 Error que debes evitar: asumir que una puntuación alta de similitud demuestra que el fragmento responde correctamente a la pregunta.
━━━━━━━━━━━━━━━━━━
📝 CIERRE
Los embeddings permiten que una IA encuentre información por significado, incluso cuando las palabras utilizadas son diferentes.
Un principiante genera vectores y espera buenos resultados; un profesional mide la calidad de recuperación y verifica que los fragmentos seleccionados respondan realmente a las consultas.
🟢 Reto: crea una pequeña colección de documentos, vectorízala y comprueba si una búsqueda semántica encuentra la información correcta.