📚 CLASE: Subida automática de documentos fragmentados en Azure AI Search
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
Automatizar la carga de documentos fragmentados permite incorporar grandes volúmenes de información a un sistema RAG sin procesar cada archivo manualmente.
El objetivo es construir un flujo repetible que transforme documentos en fragmentos consultables y controle los errores durante la indexación.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
- 🔵 Fragmentación: divide documentos extensos en unidades pequeñas que pueden recuperarse individualmente.
- 🔵 Indexación: incorpora los fragmentos al índice para permitir búsquedas posteriores.
- 🟢 Automatización: procesa múltiples documentos mediante un flujo programado en lugar de cargarlos manualmente.
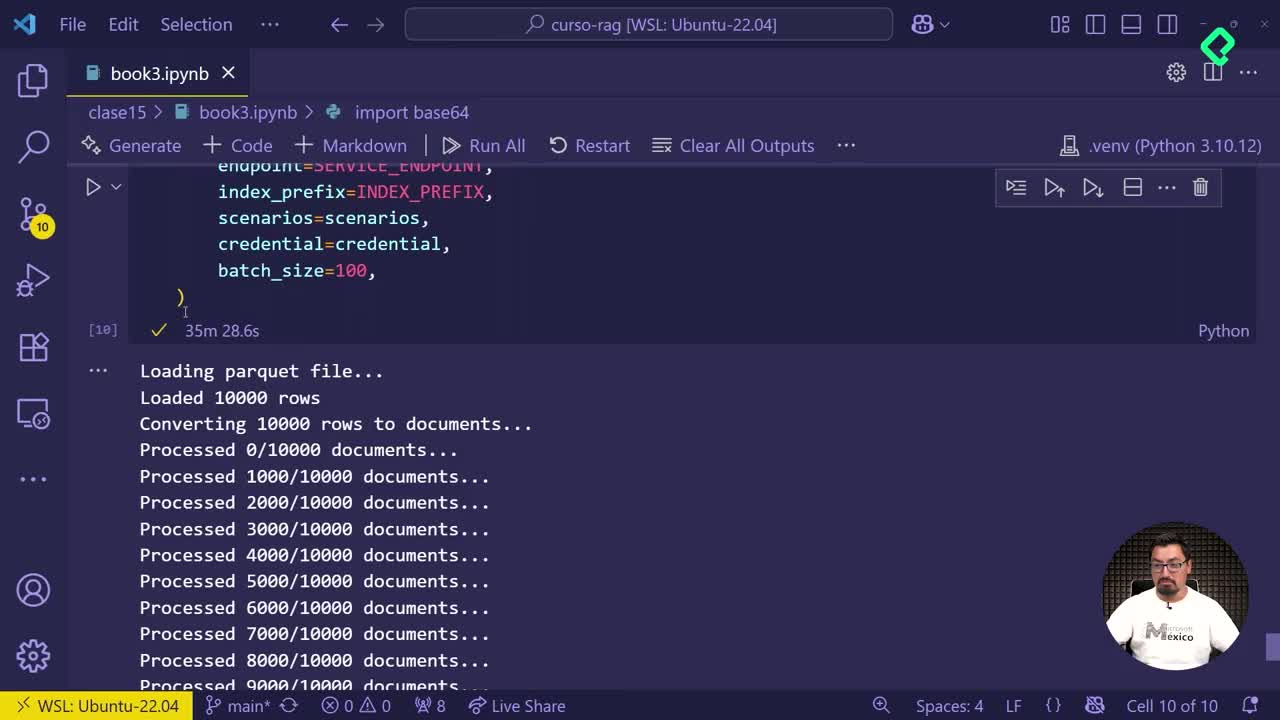
- 🟡 Procesamiento por lotes: agrupa fragmentos para gestionar mejor las cargas y los límites del servicio.
- 🔴 Validación: una ejecución terminada no garantiza que todos los documentos se hayan indexado correctamente.
━━━━━━━━━━━━━━━━━━
🔑 LO IMPORTANTE
- 🔵 Cada fragmento debe conservar una referencia al documento original para facilitar su identificación.
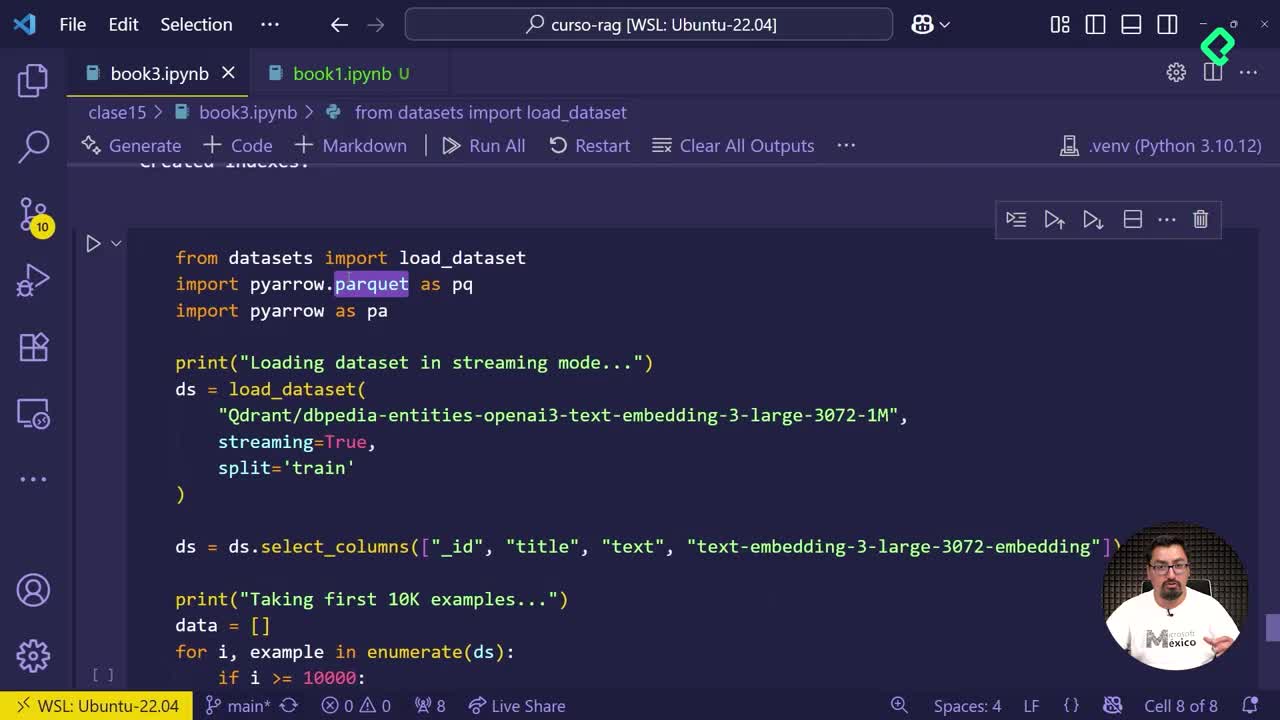
- 🟢 Automatiza la extracción del texto, la fragmentación, la generación de embeddings y la carga al índice.
- 🟡 Ajusta el tamaño y el solapamiento de los fragmentos según el contenido y las preguntas esperadas.
- 🔴 No confundas fragmentar documentos con dividir únicamente una lista en grupos para enviarlos al servicio.
- 🟢 Registra los fragmentos procesados, los errores y los documentos pendientes.
- 🔴 Evita duplicados cuando ejecutes nuevamente el proceso de carga.
- 🟡 Procesar por lotes mejora el control del flujo, pero debes respetar los límites de solicitudes de Azure AI Search.
- 🟢 Verifica los resultados mediante consultas reales después de completar la indexación.
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
🟣 Ingesta automatizada = extraer → fragmentar → vectorizar → cargar → verificar.
- 🔵 Extraer: obtener el texto de los documentos.
- 🔵 Fragmentar: dividir el texto en unidades recuperables.
- 🔵 Vectorizar: generar los embeddings necesarios para la búsqueda vectorial.
- 🟢 Cargar: enviar los registros al índice mediante lotes controlados.
- 🟢 Verificar: confirmar que los fragmentos existen y pueden recuperarse.
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES PARA HOY
- 🟢 Selecciona tres PDFs de prueba y define una carpeta de entrada.
- 🟢 Extrae el texto de cada archivo y genera fragmentos con identificadores únicos.
- 🟢 Guarda el nombre del documento de origen y el número de fragmento como metadatos.
- 🟢 Configura la generación de embeddings y la carga por lotes a Azure AI Search.
- 🟢 Añade registros de errores para identificar qué archivos o fragmentos fallaron.
- 🟢 Ejecuta el proceso dos veces y comprueba que no genere duplicados.
- 🟢 Realiza consultas sobre los tres documentos y valida los resultados recuperados.
━━━━━━━━━━━━━━━━━━
🟣 VENTAJA PROFESIONAL
- 🟣 Buena práctica adicional: utiliza identificadores deterministas para que puedas reconocer los mismos fragmentos entre ejecuciones.
- 🟣 Implementa reintentos con espera progresiva para recuperarte de errores temporales y límites de solicitudes.
- 🟣 Conserva un registro de cada ejecución con fecha, cantidad de documentos, fragmentos procesados y errores.
- 🟡 Separa la ingesta de documentos de las consultas del usuario para facilitar el mantenimiento y la depuración.
- 🔴 No reemplaces documentos existentes sin definir cómo eliminar o actualizar sus fragmentos anteriores.
- 🟣 Para grandes volúmenes, evalúa el procesamiento incremental y la concurrencia controlada antes de aumentar la capacidad.
━━━━━━━━━━━━━━━━━━
📝 CIERRE
Un principiante automatiza la carga de documentos. Un profesional construye un proceso repetible, verificable y resistente a errores, que mantiene actualizado el conocimiento de su sistema RAG.
🟢 Reto práctico: procesa tres PDFs automáticamente, ejecuta la ingesta dos veces y demuestra que puedes consultar sus contenidos sin crear duplicados.